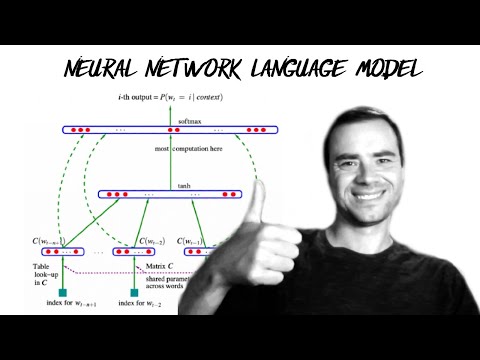
Building makemore Part 2: Multi-Layer Perceptron Language Models (Bengio et al. 2003)

Implements Bengio et al.'s landmark 2003 neural probabilistic language model from scratch: learned token embeddings, mini-batch SGD, learning-rate finder sweeps, and train/dev/test splits.
We implement a multilayer perceptron (MLP) character-level language model. In this video we also introduce many basics of machine learning (e.g. model training, learning rate tuning, hyperparameters, evaluation, train/dev/test splits, under/overfitting, etc.).
Links:
- makemore on github: https://github.com/karpathy/makemore
Previous · Lecture 2
Spelled-Out Intro to Language Modeling: Building makemore (Bigram & Cross-Entropy)
Next · Lecture 4Building makemore Part 3: Activations, Gradients, Kaiming Init & BatchNorm
Comments
Add a comment...Sign in